Vibe Coding trifft Agentic Coding: Warum Playwright-Tests entscheidend sind
KI-Agenten schreiben Code schnell. Eine durchdachte Test-Harness mit Playwright macht kritische Regressionen vor dem Release sichtbar.
Veröffentlicht:
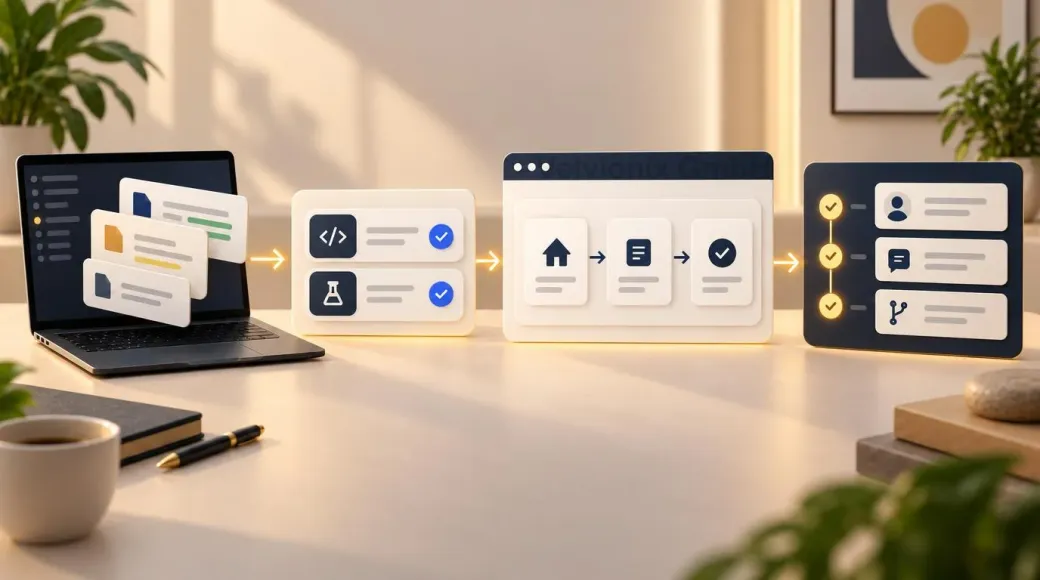 © Velvionix
Mit KI-Coding-Agenten lassen sich neue Funktionen heute oft in kurzer Zeit umsetzen. Wenn sich die geänderte Oberfläche im Browser wie erwartet verhält, scheint die Aufgabe zunächst erledigt. Ob dabei ein bereits vorhandener Ablauf beeinträchtigt wurde, lässt sich daraus allerdings nicht ableiten. Gerade bei Anwendungen mit mehreren Benutzerrollen kann eine neue Berechtigung beispielsweise dazu führen, dass eine bisher funktionierende Freigabe plötzlich nicht mehr möglich ist.
Regressionen sind kein neues Problem der Softwareentwicklung. Werden Änderungen jedoch schneller und in größerem Umfang umgesetzt, braucht das Team umso zuverlässigere Rückmeldungen darüber, ob wichtige Funktionen weiterhin funktionieren. Entscheidend ist deshalb nicht, wie viel Code ein Agent erzeugt oder wie viele Tests er ausführt, sondern welche Anforderungen diese Prüfungen tatsächlich absichern.
Das Wichtigste in Kürze
Vibe Coding ist nicht dasselbe wie Agentic Engineering
Beim Vibe Coding wird eine Idee mithilfe von KI möglichst unmittelbar in funktionierenden Code übersetzt. Der Begriff ist nicht einheitlich definiert, bezeichnet aber häufig eine Arbeitsweise, bei der die technische Umsetzung kaum im Detail überprüft wird. Für ein Experiment kann das genügen; soll die Anwendung später jedoch zuverlässig genutzt und weiterentwickelt werden, reicht eine überzeugende Oberfläche als Qualitätsnachweis nicht aus.
Beim Agentic Coding geht die Arbeit des KI-Systems über einzelne Codevorschläge hinaus. Ein Coding-Agent kann das Repository analysieren, Änderungen selbstständig umsetzen, Werkzeuge aufrufen und auf Testergebnisse reagieren. Ob daraus ein kontrollierter Entwicklungsprozess wird, hängt jedoch davon ab, welche Anforderungen, Grenzen und Prüfmöglichkeiten ihm zur Verfügung stehen.
Martin Fowler unterscheidet deshalb ausdrücklich zwischen Vibe Coding, bei dem die Überprüfung des Codes in den Hintergrund tritt, und Agentic Engineering, bei dem Entwickler die Agentenarbeit bewusst steuern, Ergebnisse kontrollieren und die Verantwortung behalten. Für Teams, die ihre Software langfristig betreiben möchten, ist diese Unterscheidung wichtiger als die Frage, welches KI-Modell den Code geschrieben hat.
Warum erfolgreiche Änderungen trotzdem Regressionen auslösen können
Ein Coding-Agent kann eine Anforderung korrekt umsetzen und zugleich eine andere Geschäftsregel verletzen, die bei der Aufgabenbeschreibung nicht berücksichtigt wurde. Das lässt sich besonders gut an Anwendungen erkennen, in denen Berechtigungen, Statuswechsel und mehrere voneinander abhängige Arbeitsschritte zusammenkommen. Dort entscheidet nicht allein die neue Funktion darüber, ob die Änderung erfolgreich war; auch die bestehenden Abläufe müssen weiterhin funktionieren.
Dass KI-Agenten viele Dateien in kurzer Zeit verändern können, macht dieses Problem nicht grundsätzlich neu. Es erhöht aber die Bedeutung von Rückmeldungen, die über einen erfolgreichen Build und fehlerfreie Typprüfung hinausgehen. Eine Anwendung kann technisch problemlos starten, obwohl Nutzer einen wichtigen Vorgang nicht mehr abschließen können.
Auch die Forschung beschäftigt sich mit dieser Grenze. Eine explorative Untersuchung von Mock und Russo aus dem Jahr 2026 verglich unterschiedliche Formen der Zusammenarbeit zwischen Menschen und KI bei testgetriebener Entwicklung. Die Ergebnisse legen nahe, dass agentische Abläufe zusätzliche Implementierungsentscheidungen erzeugen können, für die keine geeigneten Tests vorliegen. Daraus lässt sich keine allgemeine Fehlerquote für KI-Software ableiten; die Studie macht jedoch deutlich, weshalb Testdesign weiterhin eine eigenständige Aufgabe bleibt.
Ein Forschungs-Preprint aus demselben Jahr untersuchte 4.882 von Coding-Agenten erzeugte Pull Requests in Java- und Python-Projekten. Dabei zeigten sich Lücken in der Abdeckung geänderter Codezeilen. Diese Untersuchung misst Code-Coverage und nicht die Wirksamkeit von Playwright-E2E-Tests. Sie unterstreicht dennoch ein grundlegendes Problem: Allein aus der Existenz automatisierter Tests lässt sich nicht schließen, dass die relevanten Risiken geprüft wurden.
Wie eine Test-Harness die Agentenarbeit absichert
Damit ein Coding-Agent seine Änderungen sinnvoll überprüfen kann, benötigt er eine Umgebung mit klaren Vorgaben und verlässlichen Rückmeldungen. Diese Umgebung wird häufig als Harness bezeichnet. OpenAI beschreibt im Zusammenhang mit Harness Engineering unter anderem strukturiertes Projektwissen, technische Regeln, automatisierte Validierung und Feedbackschleifen.
Für eine Webanwendung lassen sich daraus vier aufeinander abgestimmte Bereiche ableiten:
- Anforderungen und Grenzen: Der Agent muss wissen, welche Geschäftsregeln gelten, welche Nutzerrollen betroffen sind und welche Teile des Projekts er verändern darf.
- Schnelle technische Kontrollen: Linting, Typprüfung sowie geeignete Unit- und Integrationstests melden viele Probleme frühzeitig zurück.
- Gezielte Browserprüfungen: Playwright kontrolliert vereinbarte kritische Nutzerabläufe in einer dafür vorgesehenen Testumgebung.
- Review und Freigabe: Änderungen, Testergebnisse und offene Risiken werden nachvollziehbar dokumentiert. Unabhängige CI-Prüfungen liefern eine zusätzliche Grundlage für die Merge-Entscheidung.
Diese Schichten können Fehler nicht vollständig verhindern. Sie verbessern aber die Voraussetzungen dafür, dass der Agent konkrete Probleme erkennt, Ursachen untersucht und seine Änderungen anhand überprüfbarer Ergebnisse korrigiert.
Weshalb tausend Tests weniger wert sein können als zehn gute
Viele Testfälle zu erzeugen ist für einen KI-Agenten vergleichsweise einfach. Schwieriger ist die Entscheidung, welche Abläufe tatsächlich abgesichert werden müssen. Dafür reicht es nicht, die Oberfläche einer Anwendung zu betrachten. Entscheidend sind unter anderem Geschäftsregeln, Benutzerrollen, mögliche Fehlerfolgen und die Erwartungen an das Ergebnis einer Aktion.
Angenommen, ein automatisierter Test prüft lediglich, ob die Schaltfläche „Freigeben“ sichtbar ist. Er kann erfolgreich durchlaufen, obwohl nach dem Klick ein falscher Status gespeichert wird. Ein anderer Test könnte bei jeder kleinen Designänderung scheitern, weil er sich an einer zufälligen CSS-Struktur orientiert. In beiden Fällen entstehen Testaufwand und Laufzeit, ohne dass der geschäftskritische Ablauf zuverlässig geprüft wird.
Vor dem Schreiben neuer Tests sollten Teams deshalb einige Fragen klären:
- Welche Vorgänge sind für die Nutzer oder den Geschäftsbetrieb besonders wichtig?
- Wer darf einen Vorgang ausführen, und wer muss davon ausgeschlossen bleiben?
- Welcher Zustand muss nach einer erfolgreichen Aktion tatsächlich vorliegen?
- Welche Fehlerfälle und Grenzwerte haben relevante Auswirkungen?
- Welche Prüfungen sind auf Unit-, API- oder E2E-Ebene am sinnvollsten?
Der ISTQB-Lehrplan behandelt die risikobasierte Auswahl von Testaktivitäten als Bestandteil professioneller Qualitätssicherung. Auch Playwright empfiehlt, nutzersichtbares Verhalten zu prüfen und Tests möglichst unabhängig voneinander auszuführen. Nicht die Menge der Testfälle ist daher ausschlaggebend, sondern die Qualität ihrer Erwartungen und die Reproduzierbarkeit ihrer Ergebnisse.
Beispiel: Eine neue Benutzerrolle verändert den Freigabeprozess
Stellen Sie sich ein internes Webportal vor, in dem Mitarbeitende Anträge einreichen, die anschließend von einer Teamleitung geprüft und freigegeben werden. Künftig soll eine Stellvertretung diese Aufgabe übernehmen können. Der Coding-Agent ergänzt dafür die neue Rolle und stellt fest, dass deren Benutzerkonto die Antragsansicht öffnen kann. Ob die Freigabe unter allen vorgesehenen Berechtigungen korrekt funktioniert, ist damit allerdings noch nicht geklärt.
Ein fachlich entworfener Playwright-Test würde den Vorgang bis zum tatsächlichen Ergebnis begleiten. Er prüft beispielsweise, ob die berechtigte Stellvertretung einen offenen Antrag freigeben kann, ob der Status anschließend korrekt gespeichert wird und ob die antragstellende Person die Änderung sieht. Ein weiterer Test stellt sicher, dass nicht berechtigte Benutzer diese Aktion nicht ausführen können. Reproduzierbare Testdaten und geeignete Testkonten sorgen dafür, dass sich beide Fälle verlässlich wiederholen lassen.
Die Tests überprüfen damit nicht nur, ob die neue Ansicht im Browser erscheint, sondern schützen den Freigabeprozess, für den das Portal entwickelt wurde.
Welche Prüfungen zu welchem Zeitpunkt sinnvoll sind
Eine wachsende E2E-Suite vollständig nach jeder kleinen Änderung auszuführen, kann den Entwicklungsprozess unnötig verlängern. Werden dagegen immer nur die Tests gestartet, die unmittelbar zur geänderten Datei passen, bleiben möglicherweise Auswirkungen auf andere Bereiche unentdeckt. Sinnvoll ist deshalb eine abgestufte Ausführung, bei der das Risiko einer Änderung über den Prüfungsumfang entscheidet.
| Zeitpunkt | Geeignete Prüfungen | Ziel |
|---|---|---|
| Während der Agentenarbeit | Linting, Typprüfung, schnelle Unit-/Integrationstests und passende Playwright-Flows | Probleme früh erkennen, bevor weitere Änderungen darauf aufbauen |
| Vor Commit oder Pull Request | Relevante kritische E2E-Flows; bei unklaren Auswirkungen zusätzlich breitere Prüfungen | Die Änderung mit nachvollziehbaren Ergebnissen übergeben |
| In einer unabhängigen CI vor dem Merge | Vereinbarte Kern-Suite und weitere notwendige Qualitätsprüfungen | Eine vom Agentenlauf unabhängige Entscheidungsgrundlage schaffen |
| Regelmäßig oder vor größeren Releases | Umfangreichere Regressionstests, zusätzliche Browser/Viewports und risikobasierte Sonderfälle | Auswirkungen außerhalb des unmittelbaren Änderungsbereichs erkennen |
Ein eigens dafür vorgesehener Test-Subagent kann die passenden Prüfungen starten, Fehlerberichte und Playwright-Traces auswerten und dem Coding-Agenten die Ergebnisse zurückmelden. Wie diese Auswahl zustande kommt und wann eine Änderung gestoppt werden muss, ist jedoch Teil des Harness-Designs. Playwright bringt die Möglichkeit mit, Tests beispielsweise über Tags gezielt auszuwählen; die Steuerung durch einen Subagenten ist eine zusätzliche Architekturentscheidung.
Die automatisierte Selbstkontrolle eines Coding-Agenten ist hilfreich, sollte aber nicht mit einer unabhängigen Freigabe verwechselt werden. Deshalb bleibt es sinnvoll, die vereinbarten Prüfungen vor dem Merge nochmals in der CI auszuführen und ihre Ergebnisse für das Team nachvollziehbar bereitzustellen.
Eine verlässliche Test-Suite benötigt laufende Pflege
Auch gut entworfene E2E-Tests funktionieren nur unter geeigneten Bedingungen. Dazu gehören kontrollierbare Testdaten, stabile Benutzerkonten, eine verlässliche Stage-/QA-/UAT-Umgebung sowie Anpassungen, wenn sich die fachlichen Abläufe verändern. Treten bei unverändertem System immer wieder wechselnde Testergebnisse auf, verliert die Suite als Grundlage für Release-Entscheidungen an Wert.
Deshalb sollte ein Team regelmäßig prüfen, welche Tests tatsächlich relevante Risiken absichern und welche nur zusätzliche Laufzeit oder Pflegeaufwand verursachen. Die passende Suite kann mit wenigen wichtigen Nutzerpfaden beginnen und bei Bedarf erweitert werden. Für Performance, Sicherheit, Architektur oder Datenintegrität sind je nach Anwendung weitere Verfahren erforderlich. Playwright-E2E-Tests bilden eine wertvolle Schicht der Qualitätssicherung, garantieren für sich genommen aber keine Enterprise-Reife.
Wenn viele grüne Tests falsche Sicherheit vermitteln
Ein erfolgreicher Testlauf beweist nur, dass die tatsächlich formulierten Erwartungen erfüllt wurden. Sind Geschäftsregeln, Berechtigungen oder relevante Fehlerfälle nicht Teil der Tests, können wichtige Defekte trotz vollständig grüner Ergebnisse bestehen bleiben.
Bevor weitere Tests automatisiert werden, sollten daher die kritischen Abläufe und ihre erwarteten Ergebnisse fachlich feststehen. Coding-Agenten können die Umsetzung unterstützen; die Bewertung der Risiken und die Freigabekriterien müssen nachvollziehbar bleiben.
Vom schnellen KI-Ergebnis zur wartbaren Anwendung
Die Antwort auf KI-gestützte Entwicklung besteht nicht darin, möglichst viele Prüfungen in jeden Arbeitsschritt zu packen. Ein guter QA-Prozess soll vielmehr dafür sorgen, dass Teams Änderungen zügig umsetzen können und trotzdem rechtzeitig erfahren, wenn dabei wichtige Abläufe beschädigt wurden. Dafür braucht es eine durchdachte Auswahl der Tests und eine Harness, die ihre Ergebnisse zuverlässig in den Entwicklungsprozess zurückführt.
Velvionix unterstützt Softwareteams durch QA-Beratung sowie durch die Entwicklung wartbarer Playwright-E2E-Tests für kritische Nutzerpfade, einschließlich einer vereinbarten CI-Einbindung. In diese Arbeit fließen über fünf Jahre praktische QA-Engineering-Erfahrung in einem börsennotierten Unternehmen und eine ISTQB-Zertifizierung ein. Welche Abläufe zuerst geprüft werden sollten und ob ein Pilot oder der Ausbau vorhandener Tests sinnvoller ist, klären wir anhand der tatsächlichen Anwendung und ihrer Risiken.
Häufige Fragen zu Agentic Coding und E2E-Tests
Braucht jedes Agentic-Coding-Projekt Playwright?
Nein. Playwright eignet sich besonders für browserbasierte Anwendungen, in denen wichtige Nutzerabläufe Ende zu Ende geprüft werden sollen. Bei Bibliotheken, reinen APIs oder frühen Experimenten können andere Testebenen zunächst wichtiger sein.
Kann ein Coding-Agent seine E2E-Tests selbst erstellen?
Ja, Coding-Agenten können Tests erzeugen und anhand von Fehlern verbessern. Ob die Tests die richtigen Geschäftsregeln und Risiken abdecken, muss allerdings anhand der fachlichen Anforderungen bewertet werden.
Muss die gesamte Test-Suite vor jedem Commit laufen?
Nicht zwingend. Während der Entwicklung können gezielte Prüfungen ausreichen, sofern zusätzlich eine sinnvolle unabhängige CI-Prüfung vor dem Merge vorgesehen ist. Welche Tests wann laufen, hängt vom Risiko der Änderung ab.
Welche weiteren Schichten gehören zu einer Coding-Harness?
Je nach Projekt gehören dazu dokumentierte Anforderungen, Architekturgrenzen, statische Analysen, Unit- und Integrationstests, Reviews sowie eine strukturierte Rückmeldung an den Agenten. Playwright ergänzt diese Bausteine dort, wo Browserabläufe geprüft werden sollen.
Wie beginnt man mit einer vorhandenen, kaum getesteten Webanwendung?
Zunächst werden die wichtigsten Nutzerpfade, Risiken und Voraussetzungen der Testumgebung geklärt. Anschließend können wenige repräsentative Abläufe automatisiert werden, bevor die Suite auf einer verlässlichen Grundlage erweitert wird.
Welche Abläufe müssen bei Ihrem nächsten Release funktionieren?
Wenn Ihr Team mit Coding-Agenten entwickelt und kritische Funktionen gezielt absichern möchte, erfahren Sie auf unserer Seite zur E2E-Testautomatisierung mit Playwright, wie wir vorgehen. Im technischen Erstgespräch können wir gemeinsam klären, welche Prüfungen den größten Nutzen bringen und welche Voraussetzungen dafür benötigt werden.
Quellen
Hinweis: Für die Inhalte externer Links sind ausschließlich deren jeweilige Anbieter oder Betreiber verantwortlich.
- [1]
- [2] OpenAI : "Harness engineering: leveraging Codex in an agent-first world"
https://openai.com/index/harness-engineering/ - [3] Moritz Mock und Barbara Russo : "Vibe Coding: An experiment with test-driven development"
https://link.springer.com/article/10.1007/s10664-026-10950-z - [4] Atish Kumar Dipongkor, Talank Baral, Wing Lam und Kevin Moran : "Test Coverage Analysis of Agentic Pull Requests"
https://arxiv.org/abs/2607.18057 - [5]
- [6]
- [7]
- [8] ISTQB : "Certified Tester Foundation Level (CTFL) v4.0"
https://istqb.org/certifications/certified-tester-foundation-level-ctfl-v4-0/
Kommentare
Noch keine Kommentare vorhanden.
Schreiben Sie den ersten Kommentar!
Kommentar schreiben
Um einen Kommentar zu verfassen, aktivieren Sie bitte die Kommentarfunktion in Ihren Datenschutz-Einstellungen.
Kommentar schreiben